Redis集群能否保证强一致性?
Redis集群本身不能保证强一致性,因为它采用的是分片(sharding)的方式来水平扩展,数据被分布存储在不同的节点上。在Redis集群中,数据的写入是通过将数据分散存储在不同节点上来实现水平扩展的,每个节点只负责管理部分数据。这种设计使得Redis集群在某些情况下可能会出现数据不一致的情况,即可能存在数据写入一个节点成功,但由于某些节点未及时同步或者网络延迟等原因,导致其他节点上的数据并未更新的情况。
哈希算法
哈希取余算法
一致性哈希算法
哈希槽算法
单节点Redis的问题
- 数据丢失问题
- 描述:Redis是内存存储,服务重启可能会丢失数据
- 解决:实现Redis数据持久化
- 并发能力问题
- 描述:单节点Redis并发能力虽然不错,但也无法满足如618这样的高并发场景
- 解决:搭建主从集群,实现读写分离
- 存储能力问题
- 描述:Redis基于内存,单节点能存储的数据量难以满足海量数据需求
- 解决:搭建分片集群,利用插槽机制实现动态扩容
- 故障恢复问题
- 描述:如果Redis宕机,则服务不可用,需要一种自动的故障恢复手段
- 解决:利用Redis哨兵,实现健康检测和自动恢复
Redis 持久化
以下命令触发持久化
save
bgsave
RDB snapshotting
RDB全称Redis Database Backup file(Redis数据备份文件),也被叫做Redis数据快照。简单来说就是把内存中的所有数据都记录到磁盘中。当Redis实例故障重启后,从磁盘读取快照文件,恢复数据。
快照文件称为RDB文件,默认是保存在当前运行目录。

Redis停机时会执行一次RDB。
Redis内部有触发RDB的机制,可以在redis.conf文件中找到,格式如下:
# 文件保存的路径目录
dir ./dumpfiles

# 每过900s进行一次检查,若至少有1个key被修改,则执行bgsave,如果是save "" 则表示禁用自动RDB
save 900 1
save 300 10
save 60 10000

# 是否压缩 ,建议不开启,压缩也会消耗cpu,磁盘的话不值钱 yes no
rdbcompression no

# RDB文件名称,推荐使用dump
dbfilename dump6379.rdb

# bgsave发生错误时停止Redis写入操作
stop-writes-on-bgsave-error yes

# rdb生成后进行校验,需要一定性能牺牲
rdbchecksum no

# 控制在删除 RDB 文件时是否使用同步操作
rdb-del-sync-files no
bgsave开始时会fork主进程得到子进程,子进程共享主进程的内存数据。完成fork后读取内存数据并写入 RDB 文件。
fork采用的是copy-on-write技术:
- 当主进程执行读操作时,访问共享内存;
- 当主进程执行写操作时,则会拷贝一份数据,执行写操作。
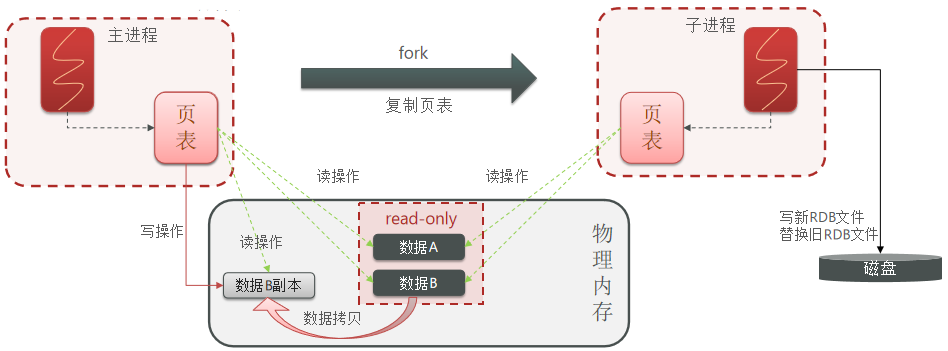
RDB方式bgsave的基本流程?
fork主进程得到一个子进程,共享内存空间
子进程读取内存数据并写入新的RDB文件
用新RDB文件替换旧的RDB文件。
RDB会在什么时候执行?save 60 1000代表什么含义?
默认是服务停止时。
代表60秒内至少执行1000次修改则触发RDB
RDB的缺点?
RDB执行间隔时间长,两次RDB之间写入数据有丢失的风险
fork子进程、压缩、写出RDB文件都比较耗时
什么时候会触发快照保存(下面任意情形)
- 配置文件中默认的快照配置
- 手动save/bgsave命令
- 执行flushall/flushdb命令也会产生dump.rdb文件,但里面是空的,无意义,两者是特殊的写操作
- 执行shutdown且没有设置开启AOF持久化
- 主从复制时,主节点自动触发
AOF
AOF全称为Append Only File(追加文件)。Redis处理的每一个写命令都会记录在AOF文件,可以看做是命令日志文件。
AOF默认是关闭的,需要修改redis.conf配置文件来开启AOF:
# 是否开启自动AOF功能,默认是no
appendonly yes
# AOF文件的名称
appendfilename "appendonly.aof"
AOF的命令记录的频率也可以通过redis.conf文件来配:
# 表示每执行一次写命令,立即记录到AOF文件
appendfsync always
# 写命令执行完先放入AOF缓冲区,然后表示每隔1秒将缓冲区数据写到AOF文件,是默认方案
appendfsync everysec
# 写命令执行完先放入AOF缓冲区,由操作系统决定何时将缓冲区内容写回磁盘
appendfsync no
| 配置项 | 刷盘时机 | 优点 | 缺点 |
|---|---|---|---|
| Always | 同步刷盘 | 可靠性高,几乎不丢数据 | 性能影响大 |
| everysec | 每秒刷盘 | 性能适中 | 最多丢失1秒数据 |
| no | 操作系统控制 | 性能最好 | 可靠性较差,可能丢失大量数据 |
因为是记录命令,AOF文件会比RDB文件大的多。而且AOF会记录对同一个key的多次写操作,但只有最后一次写操作才有意义。通过执行bgrewriteaof命令,可以让AOF文件执行重写功能,用最少的命令达到相同效果。
AOF重写
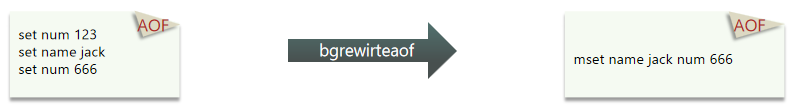
Redis也会在触发阈值时自动去重写AOF文件。阈值也可以在redis.conf中配置:
# 两者为且的条件
# AOF文件比上次文件 增长超过多少百分比则触发重写
auto-aof-rewrite-percentage 100
# AOF文件体积最小多大以上才触发重写
auto-aof-rewrite-min-size 64mb
RDB和AOF各有自己的优缺点,如果对数据安全性要求较高,在实际开发中往往会结合两者来使用。
| RDB | AOF | |
|---|---|---|
| 持久化方式 | 定时对整个内存做快照 | 记录每一次执行的命令 |
| 数据完整性 | 不完整,两次备份之间会丢失 | 相对完整,取决于刷盘策略 |
| 文件大小 | 会有压缩,文件体积小 | 记录命令,文件体积很大 |
| 宕机恢复速度 | 很快 | 慢 |
| 数据恢复优先级 | 低,因为数据完整性不如AOF | 高,因为数据完整性更高 |
| 系统资源占用 | 高,大量CPU和内存消耗 | 低,主要是磁盘IO资源但AOF重写时会占用大量CPU和内存资源 |
| 使用场景 | 可以容忍数分钟的数据丢失,追求更快的启动速度 | 对数据安全性要求较高常见 |
触发机制
自动触发
手动触发
bgrewriteaof
重写原理
Redis 7中AOF文件重写的内部执行流程是一个旨在优化AOF文件大小和提高Redis性能的过程。这个过程不仅减少了磁盘空间的占用,还能在不影响Redis服务的前提下进行。以下是AOF文件重写的详细内部执行流程:
触发重写:AOF重写可以通过执行BGREWRITEAOF命令手动触发,或者根据配置文件中的规则自动触发。自动触发通常基于文件大小的增长比例。
创建子进程:Redis通过创建一个子进程来执行AOF重写操作,这样做的好处是避免阻塞主进程,确保Redis服务的响应性。主进程继续处理客户端请求。
子进程重写AOF文件:子进程开始根据当前内存中的数据状态构建一个新的AOF文件。这个过程不会读取旧的AOF文件,而是将当前内存中的数据状态作为源数据。这意味着新的AOF文件将只包含达到当前状态所需的最小操作集。
记录增量写操作:在子进程重写AOF文件的同时,主进程会继续处理客户端请求,并将这期间的所有写操作同时记录到旧的AOF文件和一个内存缓冲区中。这保证了在AOF重写过程中,任何新的更改都不会丢失。
同步新的AOF文件:子进程完成AOF重写后,它会向主进程发送一个信号。主进程在接到这个信号后,会将步骤4中记录在内存缓冲区的增量写操作追加到新的AOF文件中。这一步确保了新的AOF文件反映了最新的数据状态。
原子替换AOF文件:一旦新的AOF文件包含了所有最新的数据,Redis会原子性地将旧的AOF文件替换为新的AOF文件。这个替换操作是通过重命名文件来完成的,确保了操作的原子性。
完成重写过程:新的AOF文件替换旧文件后,AOF重写过程完成。此时,Redis会继续使用新的AOF文件来记录后续的写操作。
这个过程优化了AOF文件的大小,提高了Redis的性能,同时确保了数据的完整性和一致性。通过在子进程中进行大部分重写工作,Redis能够保持高性能和高可用性,即使在进行数据持久化优化操作时也是如此。
Redis集群最大节点个数是多少?
16384个,$2^{14}$,不会超过哈希槽数量
Redis集群如何选择数据库?
Redis集群目前无法做数据库选择,默认在0数据库。
你知道有哪些Redis分区实现方案?
客户端分区就是在客户端就已经决定数据会被存储到哪个redis节点或者从哪个
redis节点读取。大多数客户端已经实现了客户端分区。
代理分区 意味着客户端将请求发送给代理,然后代理决定去哪个节点写数据或
者读数据。代理根据分区规则决定请求哪些Redis实例,然后根据Redis的响应结果返
回给客户端。redis和memcached的一种代理实现就是Twemproxy
查询路由(Query routing) 的意思是客户端随机地请求任意一个redis实例,然后
由Redis将请求转发给正确的Redis节点。Redis Cluster实现了一种混合形式的查询
路由,但并不是直接将请求从一个redis节点转发到另一个redis节点,而是在客户端
的帮助下直接redirected到正确的redis节点。
并发竞争redis的key问题
多个线程并发操作,先判断某个key的值,若符合条件就+1,由于两者不是原子操作,会造成问题
主从
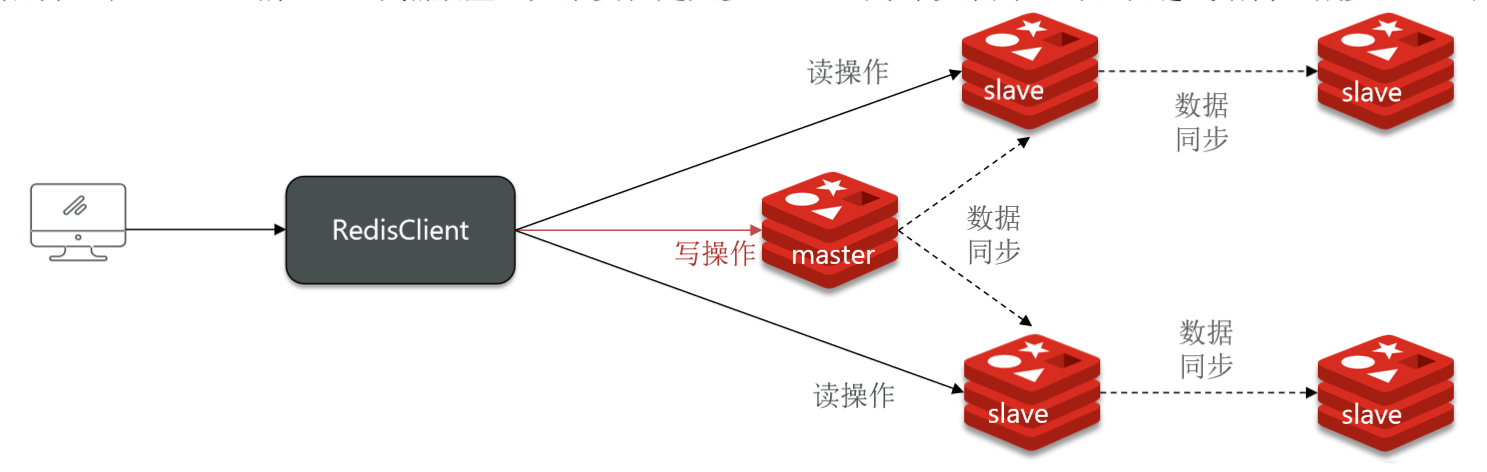
单节点Redis并发能力有限,当业务需要满足更高并发请求时,首先考虑搭建主从集群,基于读写分离提高Redis并发能力。
主节点可写可读,从节点只读,从节点从主节点同步数据。
主从集群中主节点宕机,从节点可以继续提供只读服务,随后主节点恢复,从节点可重连主节点并进行数据同步。
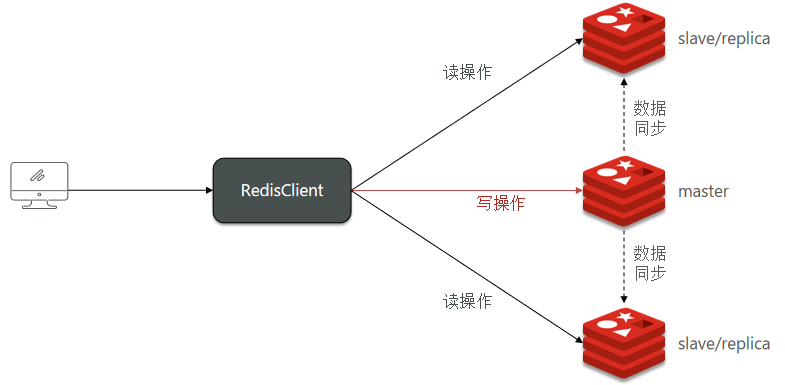
主从同步机制
解释主从复制
https://blog.csdn.net/a1076067274/article/details/109294208
假设有A、B两个Redis实例,如何让B作为A的slave节点?
在B节点执行命令:slaveof A的IP A的port
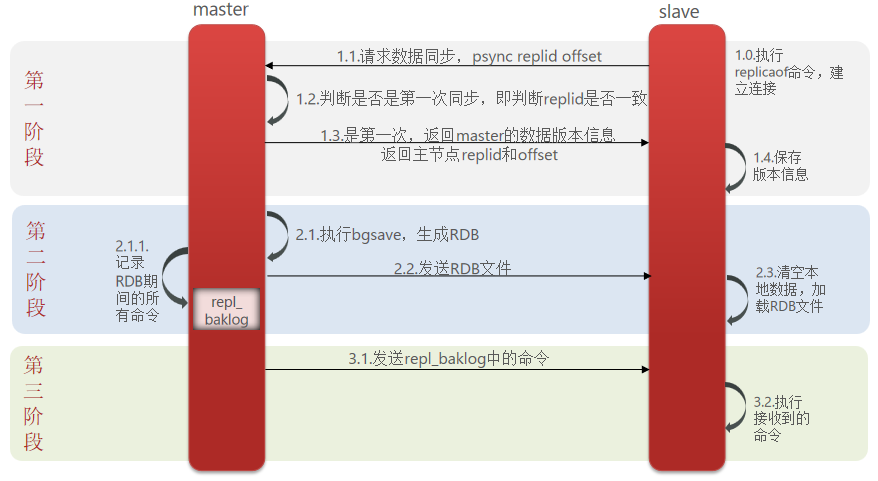
主从之前第一次同步为全量同步
Replication Id:简称replid,是数据集的标记,id一致则说明是同一数据集。每一个master都有唯一的replid,slave则会继承master节点的replid
offset:偏移量,随着记录在repl_baklog中的数据增多而逐渐增大。slave完成同步时也会记录当前同步的offset。如果slave的offset小于master的offset,说明slave数据落后于master,需要更新。
因此slave做数据同步,必须向master声明自己的replication id 和offset,master才可以判断到底需要同步哪些数据
更加详细的增量同步和全量同步解析
https://blog.csdn.net/a1076067274/article/details/109294208
全量同步
增量同步
主从第一次同步是全量同步,但如果slave重启后同步,则执行增量同步
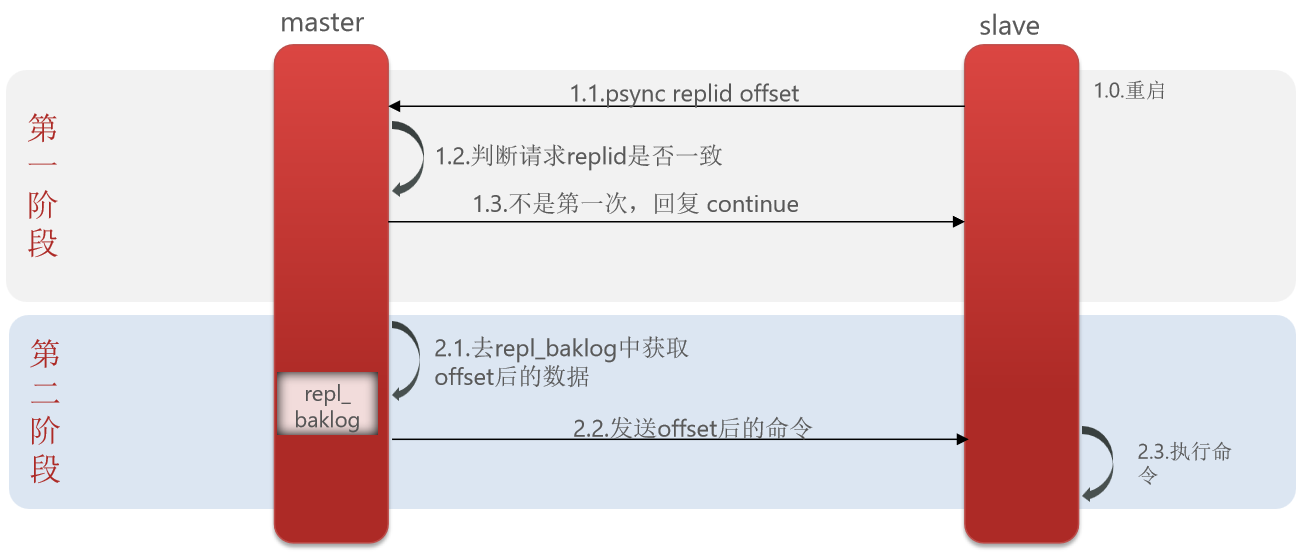
正常同步
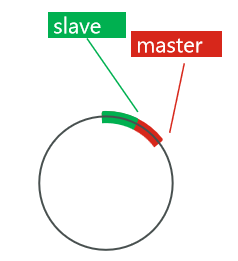
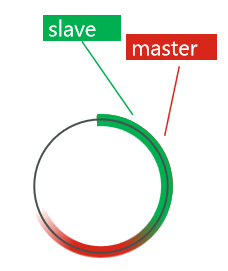
异常同步
repl_baklog大小有上限,写满后会覆盖最早的数据。如果slave断开时间过久,导致尚未备份的数据被覆盖,则无法基于log做增量同步,只能再次全量同步。
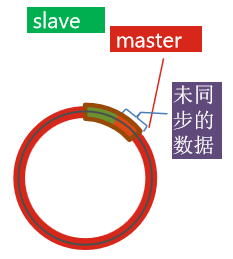
可以从以下几个方面来优化Redis主从就集群:
- 在master中配置repl-diskless-sync yes启用无磁盘复制,避免全量同步时的磁盘IO。
- Redis单节点上的内存占用不要太大,减少RDB导致的过多磁盘IO
- 适当提高repl_baklog的大小,发现slave宕机时尽快实现故障恢复,尽可能避免全量同步
- 限制一个master上的slave节点数量,如果实在是太多slave,则可以采用主-从-从链式结构,减少master压力
简述全量同步和增量同步区别?
全量同步:master将完整内存数据生成RDB,发送RDB到slave。后续命令则记录在repl_baklog,逐个发送给slave。
增量同步:slave提交自己的offset到master,master获取repl_baklog中从offset之后的命令给slave
什么时候执行全量同步?
slave节点第一次连接master节点时
slave节点断开时间太久,repl_baklog中的offset已经被覆盖时
什么时候执行增量同步?
- slave节点断开又恢复,并且在repl_baklog中能找到offset时
slave节点宕机恢复后可以找master节点同步数据,那master节点宕机怎么办?
哨兵
Redis提供了哨兵(Sentinel)机制来实现主从集群的自动故障恢复。
监控:Sentinel 会不断检查您的master和slave是否按预期工作
自动故障恢复:如果master故障,Sentinel会将一个slave提升为master。当故障实例恢复后也以新的master为主
通知:Sentinel充当Redis客户端的服务发现来源,当集群发生故障转移时,会将最新信息推送给Redis的客户端
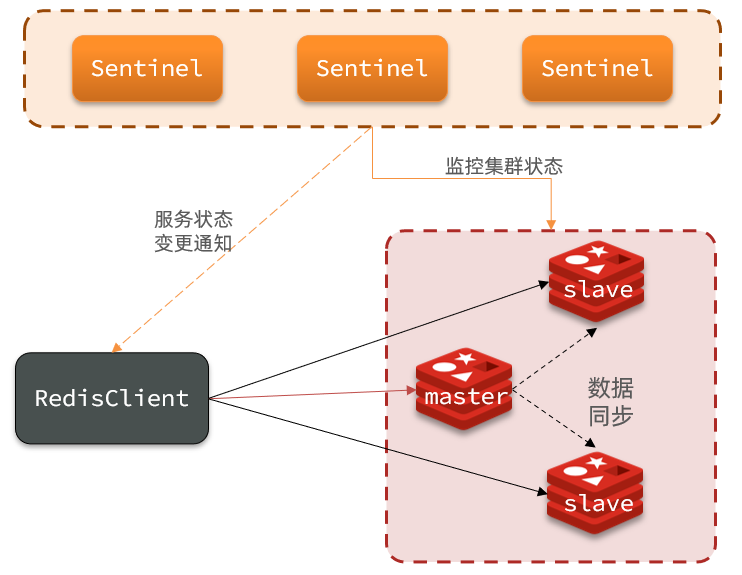
监控
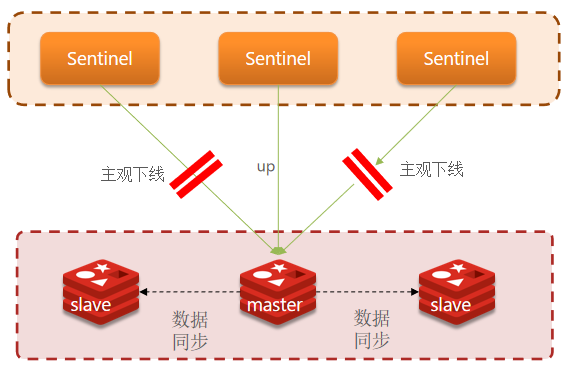
Sentinel基于心跳机制监测服务状态,每隔1秒向集群的每个实例发送ping命令:
- 主观下线:如果某sentinel节点发现某实例未在规定时间响应,则认为该实例主观下线。
- 客观下线:若超过指定数量(quorum)的sentinel都认为该实例主观下线,则该实例客观下线。quorum值最好超过Sentinel实例数量的一半。
选举
一旦发现master故障,sentinel需要在salve中选择一个作为新的master,选择依据是这样的:
- 首先会判断slave节点与master节点断开时间长短,如果超过指定值(down-after-milliseconds * 10)则会排除该slave节点
- 然后判断slave节点的slave-priority值,越小优先级越高,如果是0则永不参与选举
- 如果slave-prority一样,则判断slave节点的offset值,越大说明数据越新,优先级越高
- 最后是判断slave节点的运行id大小,越小优先级越高。
自动故障恢复
当选中了其中一个slave为新的master后(例如slave1),故障的转移的步骤如下:
- sentinel给备选的slave1节点发送slaveof no one命令,让该节点成为master
- sentinel给所有其它slave发送slaveof 192.168.150.101 7002 命令,让这些slave成为新master的从节点,开始从新的master上同步数据。
- 最后,sentinel将故障节点标记为slave,当故障节点恢复后会自动成为新的master的slave节点
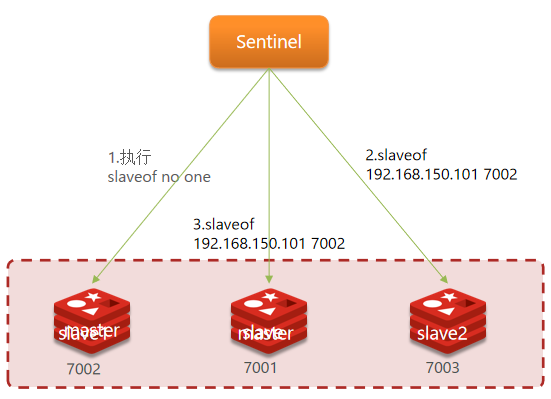
在一主两从的主从集群基础上增加由三个节点构成的哨兵集群。
Redis主节点选举机制
- 正常运行阶段
哨兵会定期查询主节点的健康状态,即为周期性的发送ping命令对主节点进行心跳检测,若每次检测都正常,则整个系统处于正常状态
- 主观下线阶段,Subjectively Down (SDown)
当某一个哨兵检测时发现主节点心跳断开,且断开时间超过了某个阈值,该哨兵主观认为主节点已下线。时间阈值由配置sentinel down-after-milliseconds <masterName> <timeout>设置。
- 客观下线阶段,Objectively Down (ODown)
当主观认为主节点已下线的哨兵数量超过某个阈值,则哨兵集群认为主节点客观下线。该阈值由配置sentinel monitor 主机名称 主机ip 主机端口 下线条件设置。
- 哨兵leader选举
当哨兵集群已确认主节点客观下线时,哨兵集群需要选举一个哨兵leader负责此次故障切换。选举算法采用Raft。
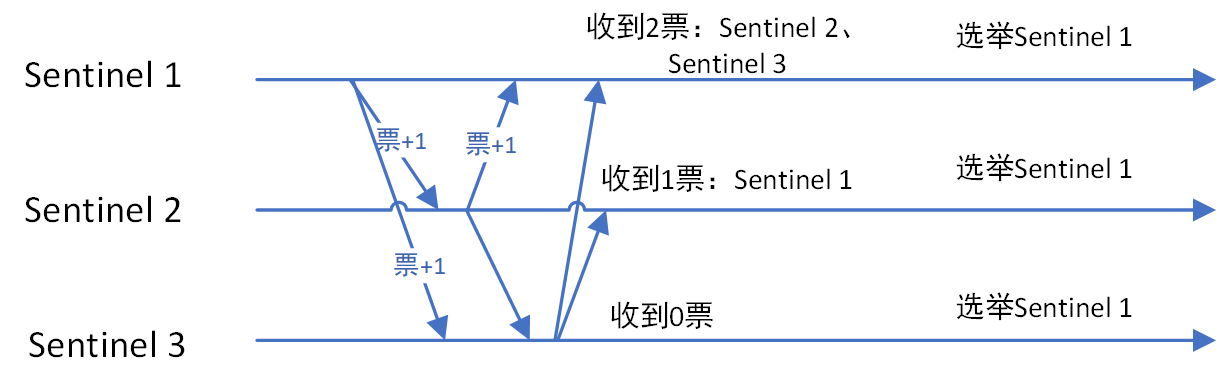
哨兵leader选择主节点
过滤故障的节点
选择优先级
slave-priority最大的从节点作为主节点,如不存在则继续选择复制偏移量(数据写入量的字节,记录写了多少数据。主服务器会把偏移量同步给从服务器,当主从的偏移量一致,则数据是完全同步)最大的从节点作为主节点,如不存在则继续
选择
runid(redis每次启动的时候生成随机的runid作为redis的标识)最小的从节点作为主节点
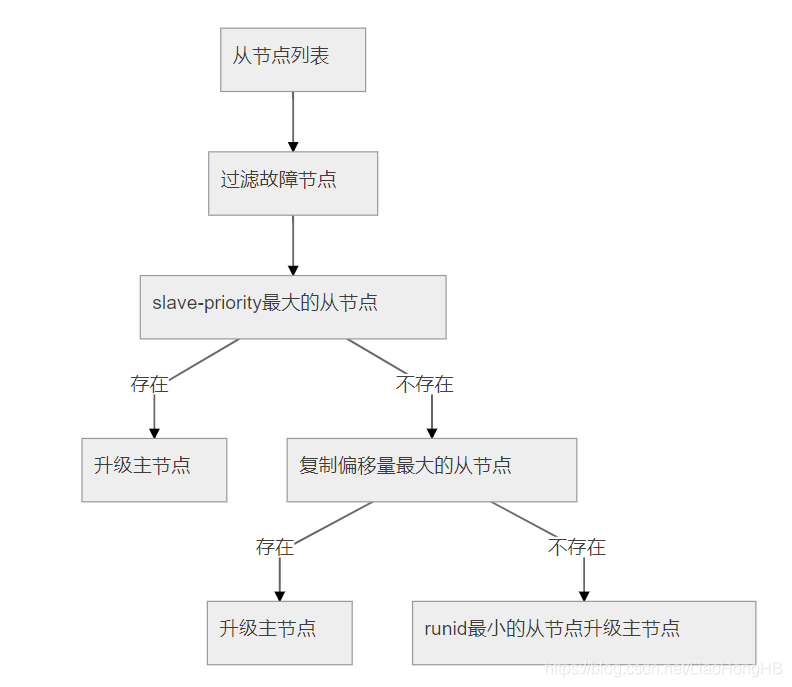
从节点升为主节点后,sentinel.conf会被动态修改,主节点信息和从节点信息会被重写
哨兵配置sentinel.conf
# sentinel端口,默认值26379
port 26379

# 是否为守护进程,默认为no,可选yes、no
daemonize yes

# 工作目录设置
dir "/home/centos/sentinel03"

# 日志文件名称,会放在工作目录下,空字符串表示日志输出到标准输出
logfile ""

# sentinel monitor <master-name> <ip> <redis-port> <quorum>
# 设置sentinel监听master的名称、IP、端口,以及指定至少有quorum个sentinel认为master离线时,master便算作真正离线
sentinel monitor mymaster 192.168.1.9 7001 2


# sentinel auth-pass <master-name> <password>
# 设置连接master和replica的密码,sentinel不支持master和replica的密码不同,因此需要保证master和replica密码相同
sentinel auth-pass mymaster 123456


# sentinel down-after-milliseconds <master-name> <milliseconds>
# 指定一个master与一个sentinel断开连接多长时间,sentinel会认为master离线。单位为毫秒,默认为3秒。
sentinel down-after-milliseconds mymaster 30000


# sentinel parallel-syncs <master-name> <numslaves>
# 指定从节点升为主节点后,最多同时可以有几个从节点进行从新的master同步数据,也意味着最多同时会有几个从节点由于全量数据同步而不可用。
# 默认值为1
sentinel parallel-syncs mymaster 1
Sentinel的三个作用是什么?
监控
故障转移
通知
Sentinel如何判断一个redis实例是否健康?
每隔1秒发送一次ping命令,如果超过一定时间没有相向则认为是主观下线
如果大多数sentinel都认为实例主观下线,则判定服务下线
故障转移步骤有哪些?
首先选定一个slave作为新的master,执行slaveof no one
然后让所有节点都执行slaveof 新master
修改故障节点,执行slaveof 新master
客户端切换
RedisTemplate的哨兵模式
在Sentinel集群监管下的Redis主从集群,其节点会因为自动故障转移而发生变化,Redis的客户端必须感知这种变化,及时更新连接信息。Spring的RedisTemplate底层利用lettuce实现了节点的感知和自动切换。
在pom文件中引入redis的starter依赖:
<dependency>
    <groupId>org.springframework.boot</groupId>
    <artifactId>spring-boot-starter-data-redis</artifactId>
</dependency>
然后在配置文件application.yml中指定sentinel相关信息
spring:
    redis:
        sentinel:
            master: mymaster # 指定master名称
                nodes: # 指定redis-sentinel集群信息
                - 192.168.150.101:27001
                - 192.168.150.101:27002
                - 192.168.150.101:27003
配置主从读写分离
@Bean
public LettuceClientConfigurationBuilderCustomizer configurationBuilderCustomizer(){
    return configBuilder -> configBuilder.readFrom(ReadFrom.REPLICA_PREFERRED);
}
这里的ReadFrom是配置Redis的读取策略,是一个枚举,包括下面选择:
- MASTER:从主节点读取
- MASTER_PREFERRED:优先从master节点读取,master不可用才读取replica
- REPLICA:从slave(replica)节点读取
- REPLICA _PREFERRED:优先从slave(replica)节点读取,所有的slave都不可用才读取master
分片
主从和哨兵可以解决高可用、高并发读的问题。但是依然有两个问题没有解决:
海量数据存储问题
高并发写的问题
使用分片集群可以解决上述问题,分片集群特征:
- 集群中有多个master,每个master保存不同数据
- 每个master都可以有多个slave节点
- master之间通过ping监测彼此健康状态
- 客户端请求可以访问集群任意节点,最终都会被转发到正确节点
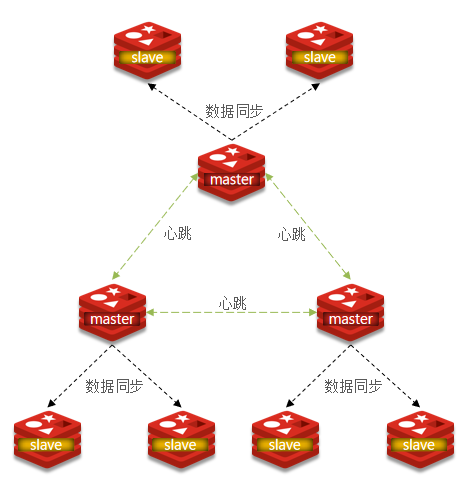
Redis.conf
bind 0.0.0.0
port 6379

save 3600 1
save 300 100
save 60 10000
dbfilename dump.rdb
dir ./
replicaof <masterip> <masterport>
replica-read-only yes
appendonly no
appendfilename "appendonly.aof"

repl-diskless-sync yes
分片集群redis.conf配置
bind 0.0.0.0
port 6379
daemonize yes
protected-mode no

databases 1

requirepass 123456
masterauth 123456

pidfile redis.pid
logfile "redis.log"

dir /usr/local/redis_cluster/redis01

dbfilename dump.rdb

appendonly yes
appendfilename "dump.aof"

# 开启集群功能
cluster-enabled yes
# 集群的配置文件名称,不需要我们创建,由redis自己维护
cluster-config-file /usr/local/redis_cluster/redis01/nodes.conf
# 节点心跳失败的超时时间
cluster-node-timeout 5000
集群
redis哨兵结点间自动发现机制
自动重写哨兵节点的配置文件
sentinel.conf,#Generated by CONFIG REWRITE
sentinel.conf中不需要手动配置其余哨兵结点和从结点的地址,哨兵会通过master获知其余哨兵结点和从结点(那链式结点呢)
在哨兵集群监管下的Redis集群,其结点会因为自动故障转移而发生变化,Redis的客户端必须感知这种变化,及时更新连接信息。Spring的RedisTemplate底层利用Lettuce实现了结点感知和自动切换
1.引入springdataredis依赖
2.配置application.yaml哨兵集群
3.配置读写策略
散列插槽
铁打的slot,流水的master
key与插槽绑定、重定向
CLUSTER COUNTKEYSINSLOT 4567
    1,该槽位被占用
        0,该槽位没占用
带通识符的set get命令
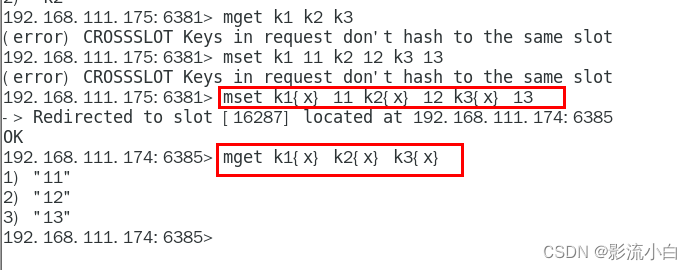
mset k1{x} v1 k2{x} v2 ...


mget k1{x} k2{x}  ...
不在同一个slot槽位下的键值无法使用mset、mget等多键操作。
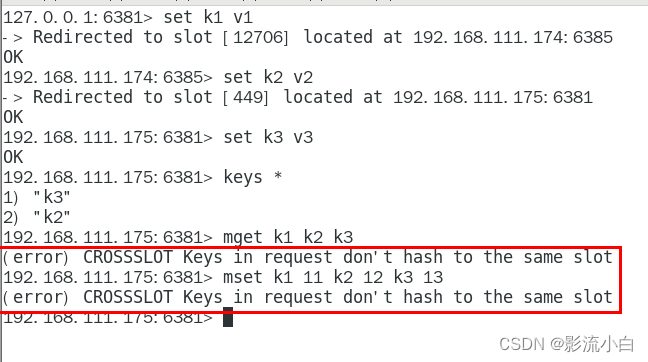
可以通过{}来定义同一个组的概念,使key中{}内相同内容的键值对放到一个slot槽位去,对照下图类似k1k2k3都映射为x,自然槽位一样。
这也就解释了为什么CRC16 算法源码 cluster.c的KeyHashSlot方法 中有对 “{” 和 “}” 的判断
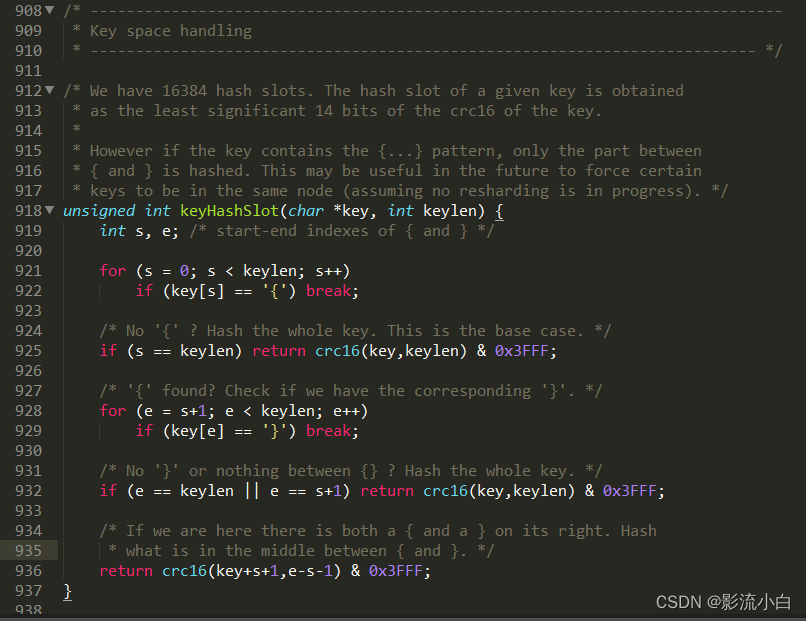
哈希函数采用CRC16
hash_slot = CRC16(key)mod 16384
redis-cli -c -p 7001
尽量避免跨结点查询,将同类数据放在同一结点上,将{keyId}…为前缀,控制key的有效部分
Redis会把每一个master节点映射到0~16383共16384个插槽(hash slot)上,查看集群信息时就能看到:
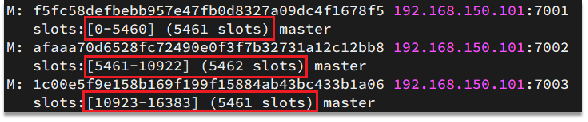
数据key不是与节点绑定,而是与插槽绑定。redis会根据key的有效部分计算插槽值,分两种情况:
key中包含”{}”,且“{}”中至少包含1个字符,“{}”中的部分是有效部分
key中不包含“{}”,整个key都是有效部分
例如:key是num,那么就根据num计算,如果是{itcast}num,则根据itcast计算。计算方式是利用CRC16算法得到一个hash值,然后对16384取余,得到的结果就是slot值。
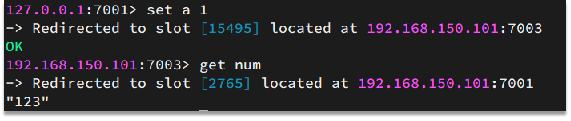
Redis如何判断某个key应该在哪个实例?
将16384个插槽分配到不同的实例
根据key的有效部分计算哈希值,对16384取余
余数作为插槽,寻找插槽所在实例即可
如何将同一类数据固定的保存在同一个Redis实例?
这一类数据使用相同的有效部分,例如key都以{typeId}为前缀
集群伸缩
添加结点,移动插槽
移动插槽,删除结点
添加一个节点到集群
redis-cli –cluster提供了很多操作集群的命令,可以通过下面方式查看:
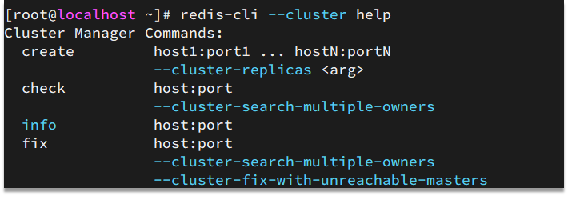
比如,添加节点的命令:
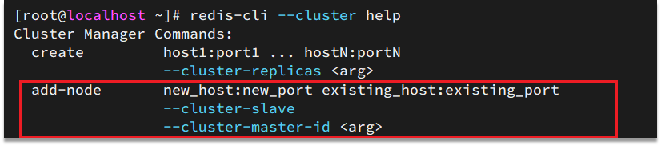
向集群中添加一个新的master节点,并向其中存储 num = 10
求:
启动一个新的redis实例,端口为7004
添加7004到之前的集群,并作为一个master节点
给7004节点分配插槽,使得num这个key可以存储到7004实例
删除集群中的一个节点
删除7004这个实例
故障转移
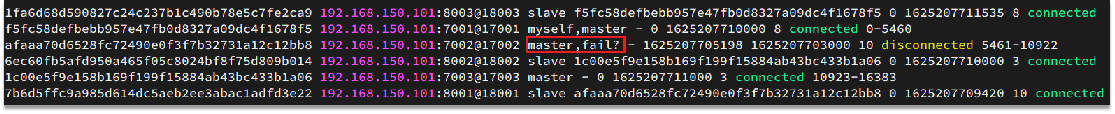
当集群中有一个master宕机会发生什么呢?
首先是该实例与其它实例失去连接
然后是疑似宕机:
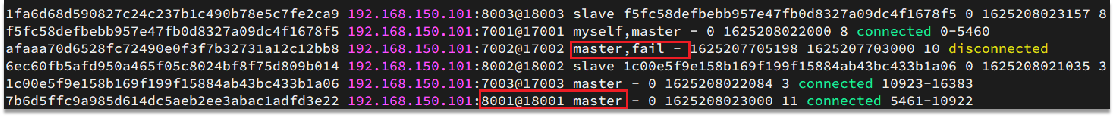
最后是确定下线,自动提升一个slave为新的master:
数据迁移
手动变更结点角色,手动故障转移
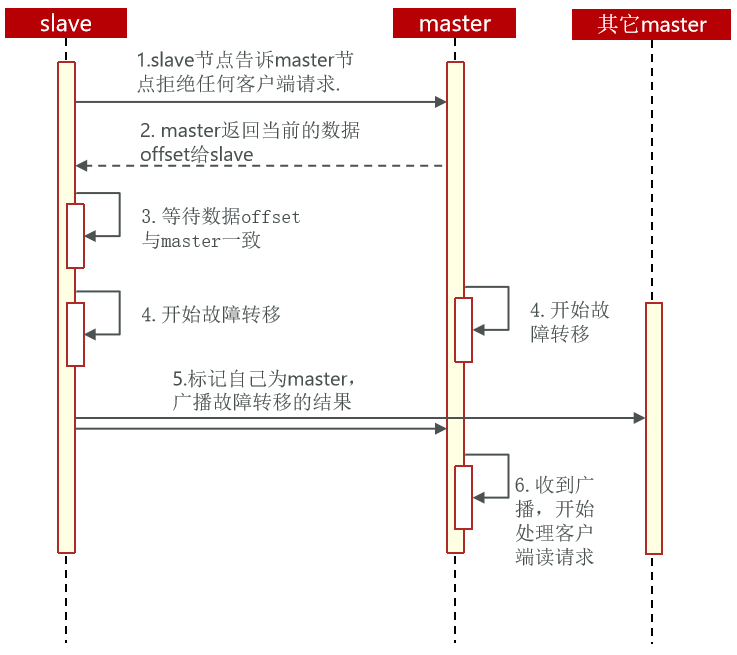
利用cluster failover命令可以手动让集群中的某个master宕机,切换到执行cluster failover命令的这个slave节点,实现无感知的数据迁移。
手动的Failover支持三种不同模式:
- 缺省:默认的流程,如图1~6歩
- force:省略了对offset的一致性校验
- takeover:直接执行第5歩,忽略数据一致性、忽略master状态和其它master的意见
RedisTemplate访问分片集群
RedisTemplate底层同样基于lettuce实现了分片集群的支持,而使用的步骤与哨兵模式基本一致:
引入redis的starter依赖
配置分片集群地址
配置读写分离
与哨兵模式相比,其中只有分片集群的配置方式略有差异,如下:
spring:
    redis:
        cluster:
            nodes: # 指定分片集群的每一个节点信息
            - 192.168.150.101:7001
            - 192.168.150.101:7002
            - 192.168.150.101:7003
            - 192.168.150.101:8001
            - 192.168.150.101:8002
            - 192.168.150.101:8003